Cette IA gratuitetourne sur ton PC…et égale GPT-6 Luna
Une IA gratuite, sans internet et sans abonnement, qui fait jeu égal avec le modèle rapide d'OpenAI. On l'a installée et testée sur une carte graphique de joueur : ce que ton PC peut vraiment faire tourner, et les vraies limites.
L'essentiel en 30 secondes
- Qwen3.8 27B, un modèle gratuit d'Alibaba, obtient 34 au classement indépendant Artificial Analysis, contre 35 pour GPT-6 Luna au même niveau de réflexion.
- Le chiffre qui compte pour faire tourner une IA chez toi : la mémoire de ta carte graphique (8, 16 ou 24 Go).
- Notre test sur une Radeon RX 7800 XT : Gemma 4 12B répond à plus de 30 tokens par seconde, sans connexion. Les meilleurs modèles payants restent devant pour les tâches complexes.
OpenAI enchaîne les sorties : GPT-6 Astra, GPT-6.1 Sol… Et pendant ce temps, une IA gratuite, que tu télécharges comme un fichier, fait jeu égal avec GPT-6 Luna, le modèle rapide de cette nouvelle génération. Sans internet, sans abonnement, directement sur une carte graphique de joueur. On l’a installée, on l’a testée, et on te dit ce que ton PC peut vraiment faire tourner.
C’est quoi, une IA locale ?
Quand tu parles à ChatGPT, ta question part sur internet, elle est traitée dans les serveurs d’OpenAI, puis la réponse revient. Une IA locale, c’est l’inverse : tout se passe dans ton ordinateur. Ta question ne sort jamais de chez toi.
C’est possible parce que de plus en plus d’entreprises publient leurs modèles en accès libre : Google avec Gemma, Alibaba avec Qwen, OpenAI aussi avec gpt-oss. Ce sont des « modèles ouverts » : tu peux les télécharger gratuitement et les faire tourner chez toi. Qwen3.8 27B, par exemple, est publié sous licence Apache 2.0 sur Hugging Face.
Le classement qui change tout
Pour savoir si ces modèles gratuits tiennent la route, on ne se fie pas aux annonces des entreprises. On s’appuie sur Artificial Analysis, un site indépendant qui fait passer les mêmes tests à toutes les IA (raisonnement, code, recherche d’informations, travail sur des documents) et en tire une note globale.
| Modèle | Type | Réglage de réflexion | Note |
|---|---|---|---|
| Claude Opus 5.5 | payant | max | 58 |
| GPT-6 Astra | payant | max | 53 |
| Gemini 4 Argon | payant | high | 53 |
| GPT-6 Luna | payant, cloud | max | 38 |
| GPT-6 Luna | payant, cloud | xhigh | 35 |
| Qwen3.8 27B | gratuit, sur ton PC | xhigh | 34 |
| Gemma 4 12B | gratuit, sur ton PC | — | 14 |
Artificial Analysis Intelligence Index v4.3.2, relevé le 25 octobre 2026. Les classements évoluent vite : vérifie les chiffres du jour.
Soyons honnêtes : aucune IA que tu peux faire tourner chez toi n’atteint le niveau des géants payants. Mais au même niveau de réflexion, Qwen3.8 27B (34) fait jeu égal avec GPT-6 Luna (35), le modèle rapide d’OpenAI, celui qu’on utilise au quotidien pour écrire, résumer ou expliquer. Poussé au maximum, Luna monte à 38 : l’écart existe, mais il est étroit.
Énorme sur le papier, mais assez petit pour tenir sur une carte graphique de joueur… à condition qu’elle ait assez de mémoire.
Paramètres de Qwen3.8 27BCe que ton PC peut faire tourner
Le chiffre qui compte, ce n’est pas la puissance de ton PC : c’est la mémoire de ta carte graphique. Pour la connaître sous Windows, ouvre le Gestionnaire des tâches, va dans Performance, clique sur ta carte graphique (GPU 0) et regarde la ligne « Mémoire du GPU dédiée ».
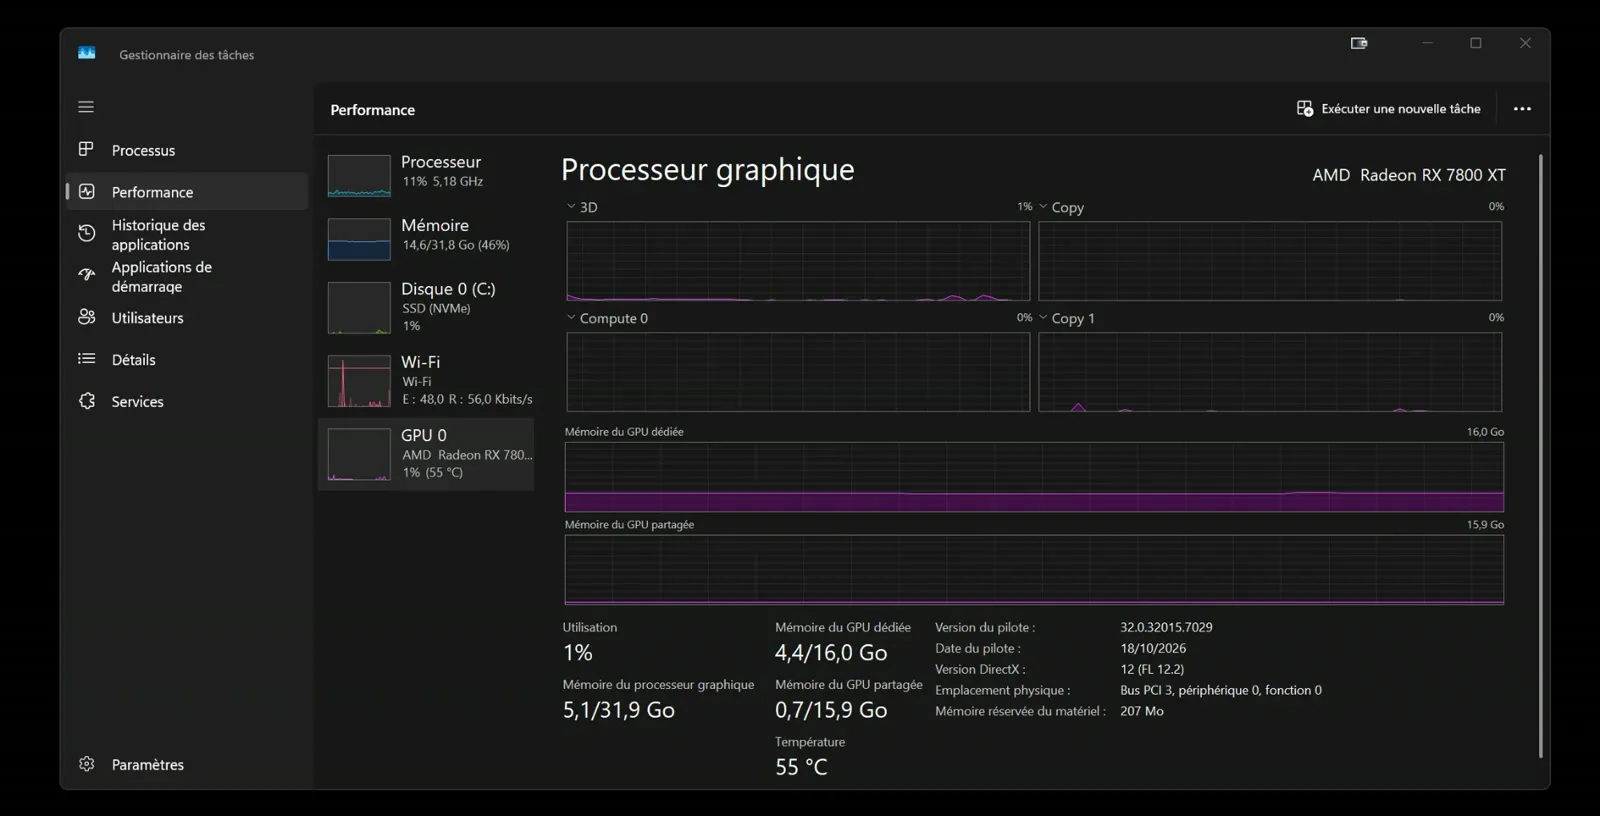
Onglet Performance › GPU 0 : ici, 16 Go de mémoire dédiée sur une Radeon RX 7800 XT.
- 8 Go : des modèles comme Qwen3 en version 8 milliards de paramètres. Parfaits pour écrire, reformuler ou résumer.
- 16 Go : Gemma 4 en version 12 milliards (Google) ou gpt-oss 20 milliards (OpenAI). Le niveau idéal pour la plupart des usages du quotidien.
- 24 Go : Qwen3.8 27B, celui qui fait jeu égal avec GPT-6 Luna.
Pourquoi c’est si important ? Le modèle doit être chargé dans la mémoire de ta carte graphique. S’il est trop gros, il déborde sur la mémoire de ton PC, et là, il devient beaucoup plus lent.
Pas de carte graphique ? Ça marche quand même avec de petits modèles de 2 à 4 Go. C’est plus lent et moins malin, mais pour reformuler un texte ou corriger une faute, ça peut suffire.
Notre test sur une Radeon RX 7800 XT
On a testé sur notre machine, avec une carte graphique de milieu de gamme : une AMD Radeon RX 7800 XT avec 16 Go de mémoire. Logiciel : LM Studio, gratuit. Modèle : Gemma 4 12B de Google, environ 7,5 Go à télécharger, à peu près la taille d’un jeu vidéo.
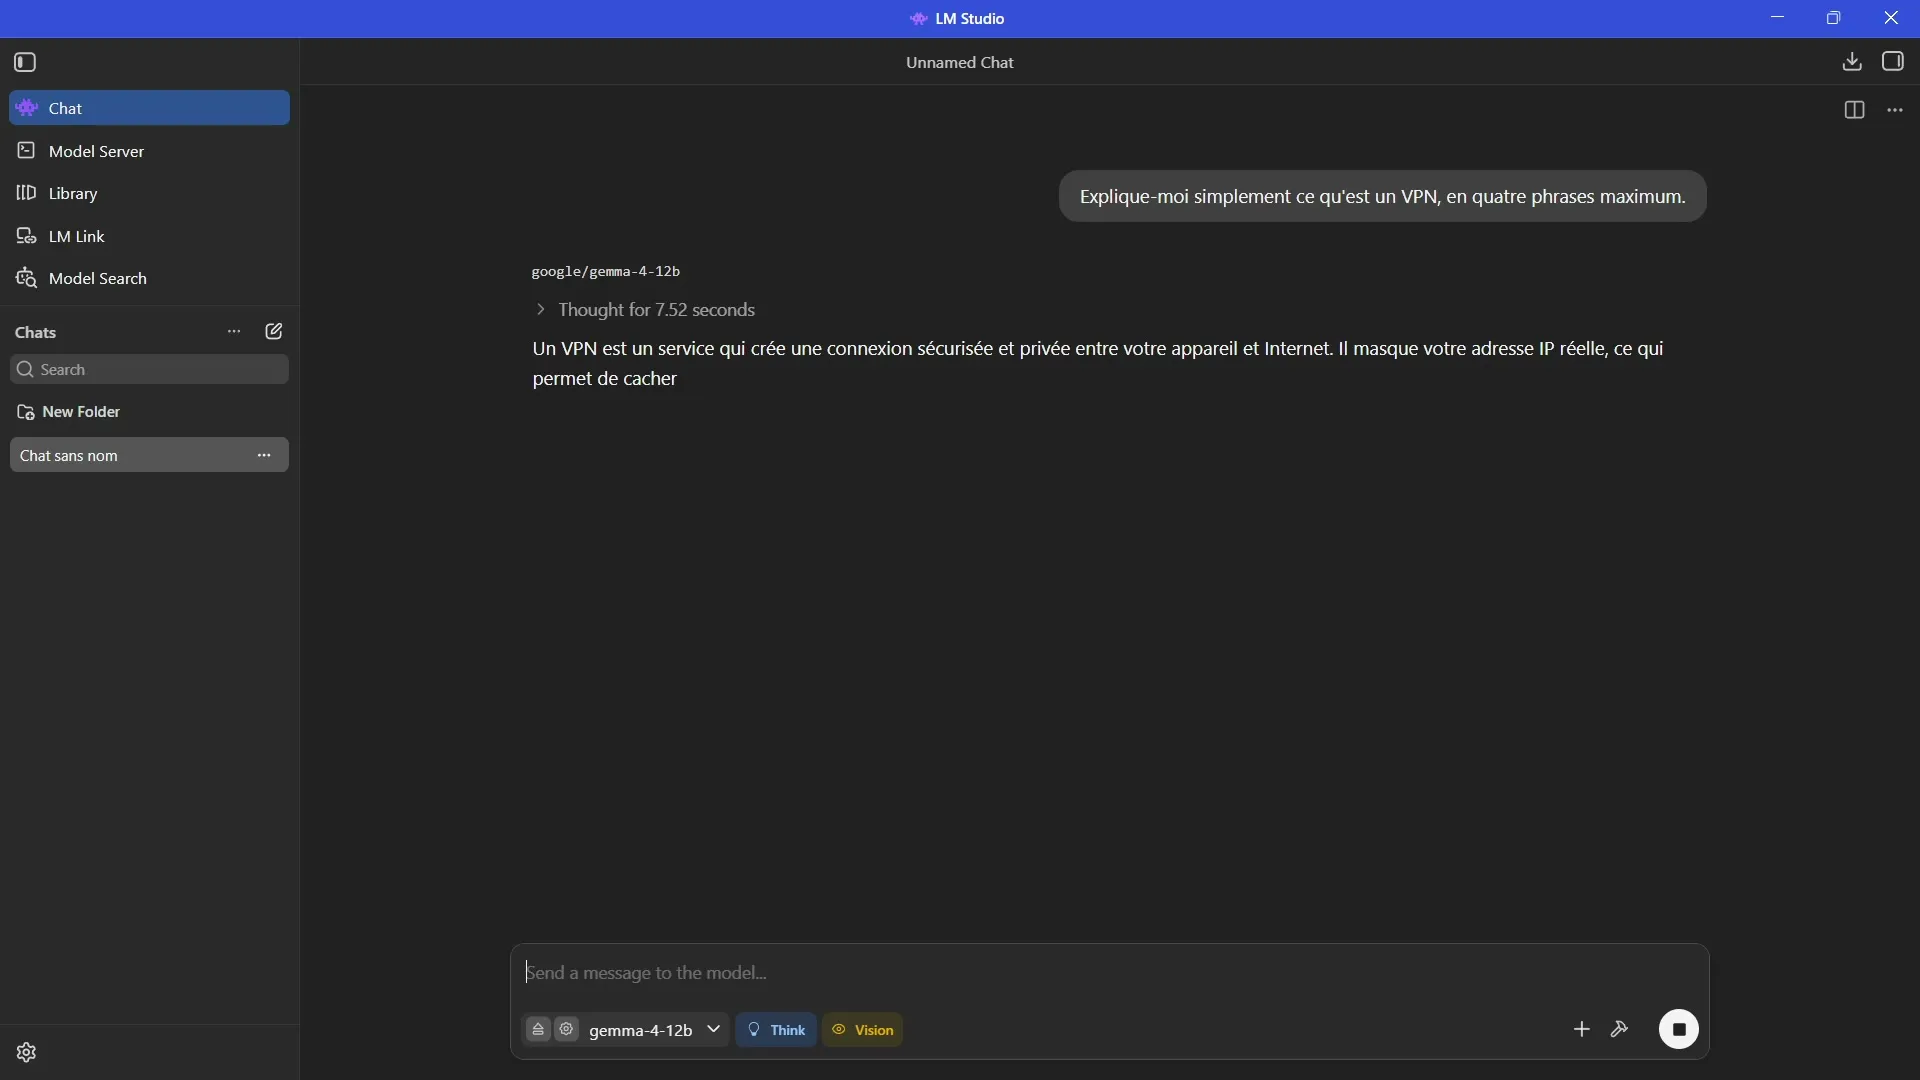
Première question : « Explique-moi simplement ce qu’est un VPN ». Réponse claire, en quatre phrases, sans jargon.
Un token, c’est un morceau de mot. À cette vitesse, la réponse s’écrit bien plus vite que tu ne peux la lire.
Test TECH'ONNECTÉ, 25 oct. 2026 : 32 à 41 tokens/s selon les questionsLe modèle se met au travail en 2,5 secondes environ, réfléchit quelques secondes, puis la réponse s’écrit. On lui a aussi demandé :
- Cinq idées de repas avec seulement des œufs, des pâtes et des tomates : pâtes à la tomate avec un œuf au plat, frittata, version shakshuka… Rien d’absurde.
- Un mail pour décaler un rendez-vous chez le dentiste : propre et poli.
- Un budget avec 1 200 € par mois et 650 € de loyer : le calcul des 550 € restants est juste.
Est-ce que c’est parfait ? Non. Il nous a dit qu’un VPN « crypte » les données, alors que le bon mot est « chiffre ». Une petite erreur, mais qui rappelle qu’il faut garder un œil critique, comme avec n’importe quelle IA.
L’installer en 3 étapes
- Installe LM Studio depuis son site officiel. L’offre de base est gratuite, y compris pour un usage professionnel interne.
- Choisis un modèle dans la recherche de modèles. LM Studio t’indique ceux qui tiennent dans ta mémoire : la pastille verte « Déchargement complet sur GPU possible » veut dire que le modèle tient entièrement dans ta carte graphique.
- Charge-le et discute. C’est tout.
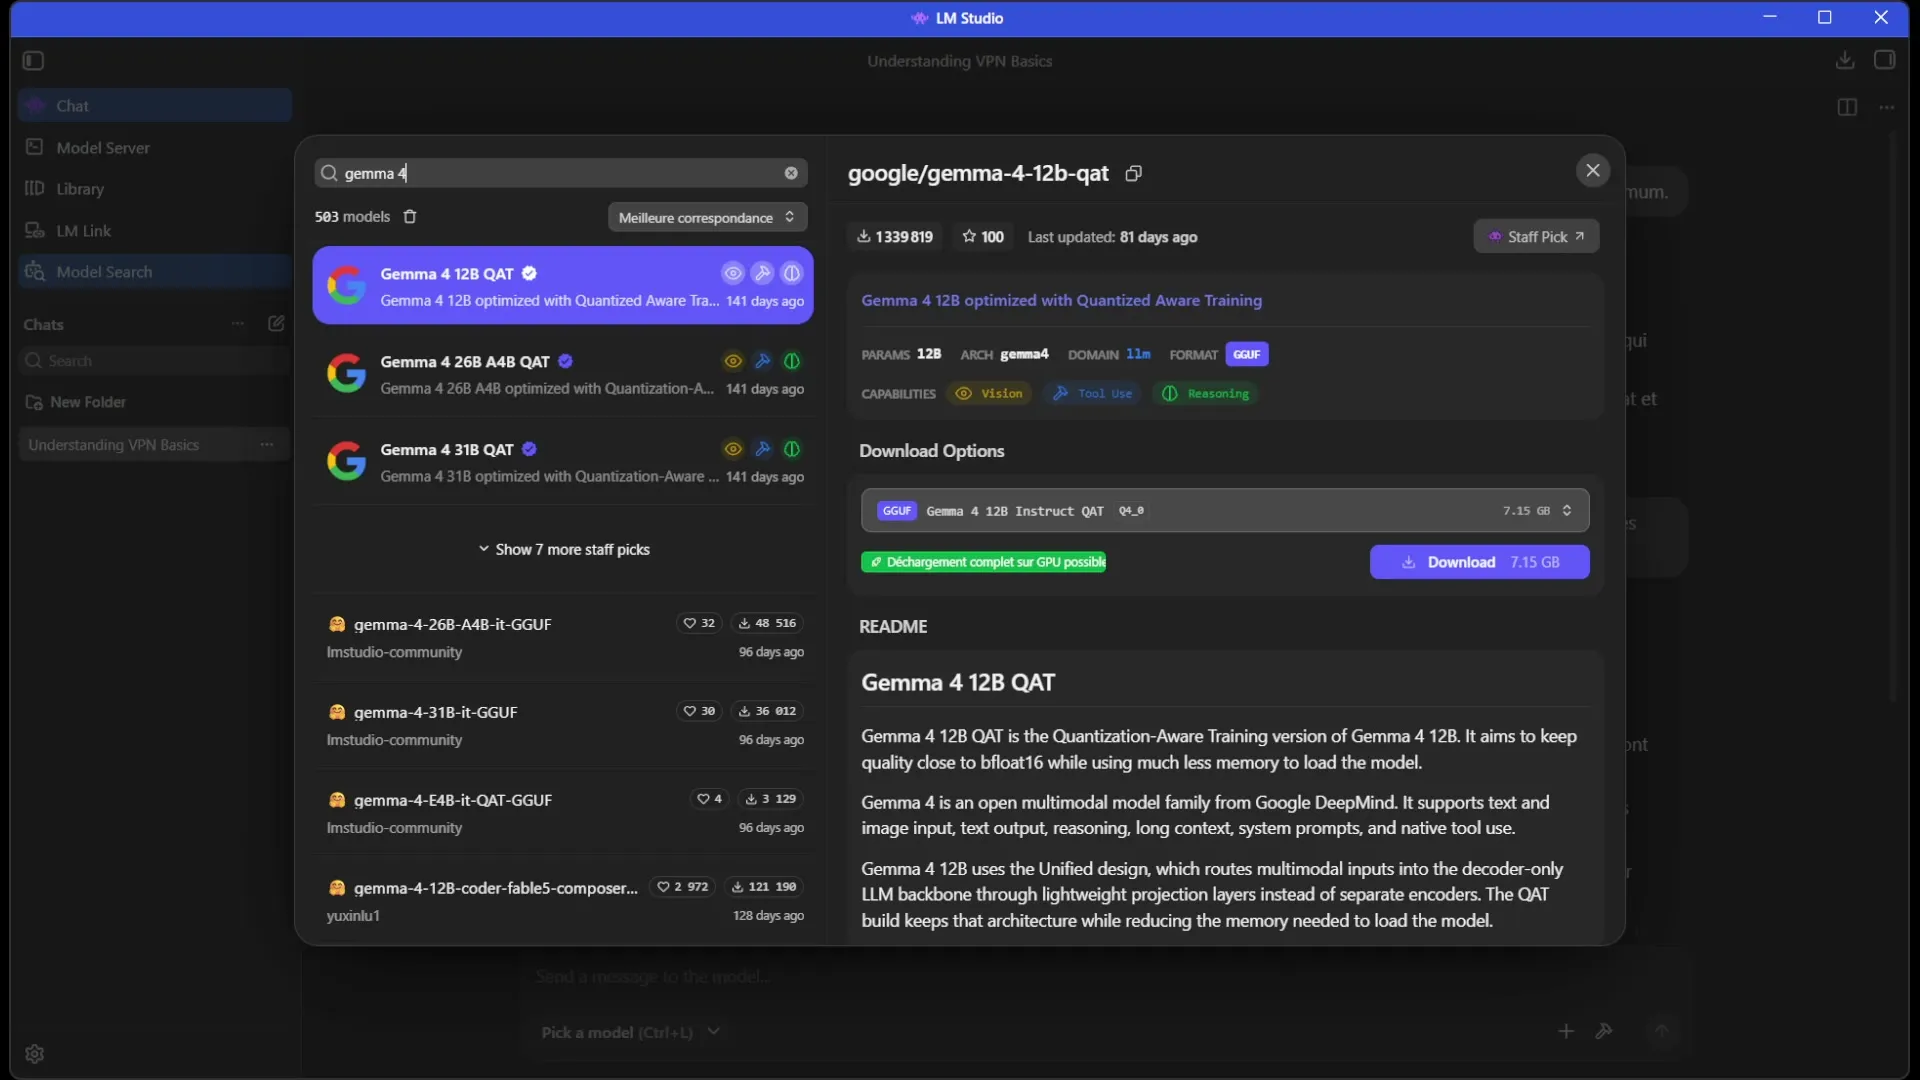
La pastille verte sous le téléchargement : ce modèle tient entièrement dans les 16 Go de la carte.
Tu es un peu plus technique ? Ollama, gratuit et open source, permet de brancher une IA locale sur d’autres logiciels. On y reviendra dans une prochaine vidéo.
Les limites
- Pas d’internet, pas d’actu : une IA locale ne connaît que ce qu’elle a appris.
- Loin des meilleurs payants sur le raisonnement complexe, le code difficile ou les longues analyses.
- Du matériel : une carte graphique avec assez de mémoire, et de la place sur ton disque.
En échange, trois avantages que le cloud ne peut pas t’offrir : c’est gratuit, ça marche sans connexion, et tes données ne quittent jamais ton ordinateur.
La vidéo
Et toi, tu as quelle carte graphique ? Dis-le en commentaire sous la vidéo, on te dira quel modèle tu peux faire tourner.
Notre avis
Bluffant pour le quotidien, pas encore au niveau des géants
Pour écrire, résumer ou expliquer, une IA locale gratuite fait déjà très bien le travail, sans abonnement ni connexion. Pour le raisonnement poussé et le code difficile, les modèles payants gardent une longueur d'avance.